Das Problem, das ein allgemeiner Chatbot nicht lösen kann
Fragen Sie einen allgemeinen Chatbot nach den Abläufen in Ihrem Unternehmen, passiert eines von zwei Dingen. Entweder sagt er, dass er es nicht weiß, oder — schlimmer — er liefert eine selbstsichere Antwort, die richtig klingt und es nicht ist. Er hat Ihre Dokumente nie gesehen und füllt die Lücke mit etwas Plausiblem.
Für ein Unternehmen ist genau das die ganze Schwierigkeit. Das Wissen, auf das es für Ihre Kunden und Mitarbeitenden ankommt, steckt in Verträgen, Regelwerken, Preislisten, Handbüchern, Beschlüssen und alten E-Mails. Ein Modell, das mit dem öffentlichen Internet trainiert wurde, hat nichts davon, und ein Modell mit Ihren Dateien neu zu trainieren, ist selten die richtige Lösung.
Was RAG tut, in einem Satz
Retrieval-augmented generation fügt vor der Antwort einen Schritt ein: Zuerst werden in Ihren Dokumenten die Passagen gesucht, die für die Frage relevant sind, dann bekommt das Modell genau diese Passagen und soll daraus antworten.
Ein Vergleich hilft. Ein allgemeiner Chatbot ist ein belesener Mensch, der aus dem Gedächtnis antwortet. Ein RAG-Assistent ist derselbe Mensch mit Ihrem Archiv auf dem Schreibtisch, der nachschlägt, bevor er spricht — und Ihnen sagen kann, von welcher Seite die Antwort stammt.
Die Dokumente vorbereiten
Der größte Teil der Arbeit geschieht, bevor überhaupt jemand eine Frage stellt. Dokumente kommen als PDFs, Scans, Tabellen und Webseiten und müssen zuerst zu sauberem, lesbarem Text werden. Gescannte Seiten brauchen Texterkennung; Tabellen und Überschriften müssen ihre Bedeutung behalten; Duplikate und veraltete Fassungen müssen entfernt oder gekennzeichnet werden.
Der Text wird dann in Passagen aufgeteilt — einen Absatz, eine Klausel, einen kurzen Abschnitt. Das nennt man Chunking. Zu lange Passagen tragen Störgeräusche in die Antwort; zu kurze verlieren ihren Zusammenhang. Jede Passage merkt sich, woher sie stammt: das Dokument, die Seite, das Datum.
Jede Passage wird anschließend in ein Embedding umgewandelt: eine Liste von Zahlen, die ihre Bedeutung abbildet. Zwei Passagen, die mit unterschiedlichen Worten über dasselbe sprechen, landen nah beieinander. Das ermöglicht die Suche nach Bedeutung statt nach exakten Wörtern, und gespeichert wird das Ganze in einer Vektordatenbank wie pgvector — der Datenbank hinter Urbano.
Die richtigen Passagen finden
Stellt jemand eine Frage, wird auch sie in ein Embedding umgewandelt, und das System sucht die Passagen, die ihr am nächsten sind. Gutes Retrieval hört dort selten auf: Es kann die Suche nach Bedeutung mit gewöhnlicher Stichwortsuche verbinden, nach Dokumenttyp oder Datum filtern und die Ergebnisse noch einmal neu ordnen, bevor irgendetwas beim Modell ankommt.
Am Retrieval entscheidet sich, ob ein RAG-System funktioniert. Wird die richtige Passage nicht gefunden, antwortet auch das beste Modell der Welt aus dem falschen Material. In einem ernsthaften Assistenten steckt der meiste Aufwand hier, nicht im Chatfenster.
Eine Antwort, die man prüfen kann
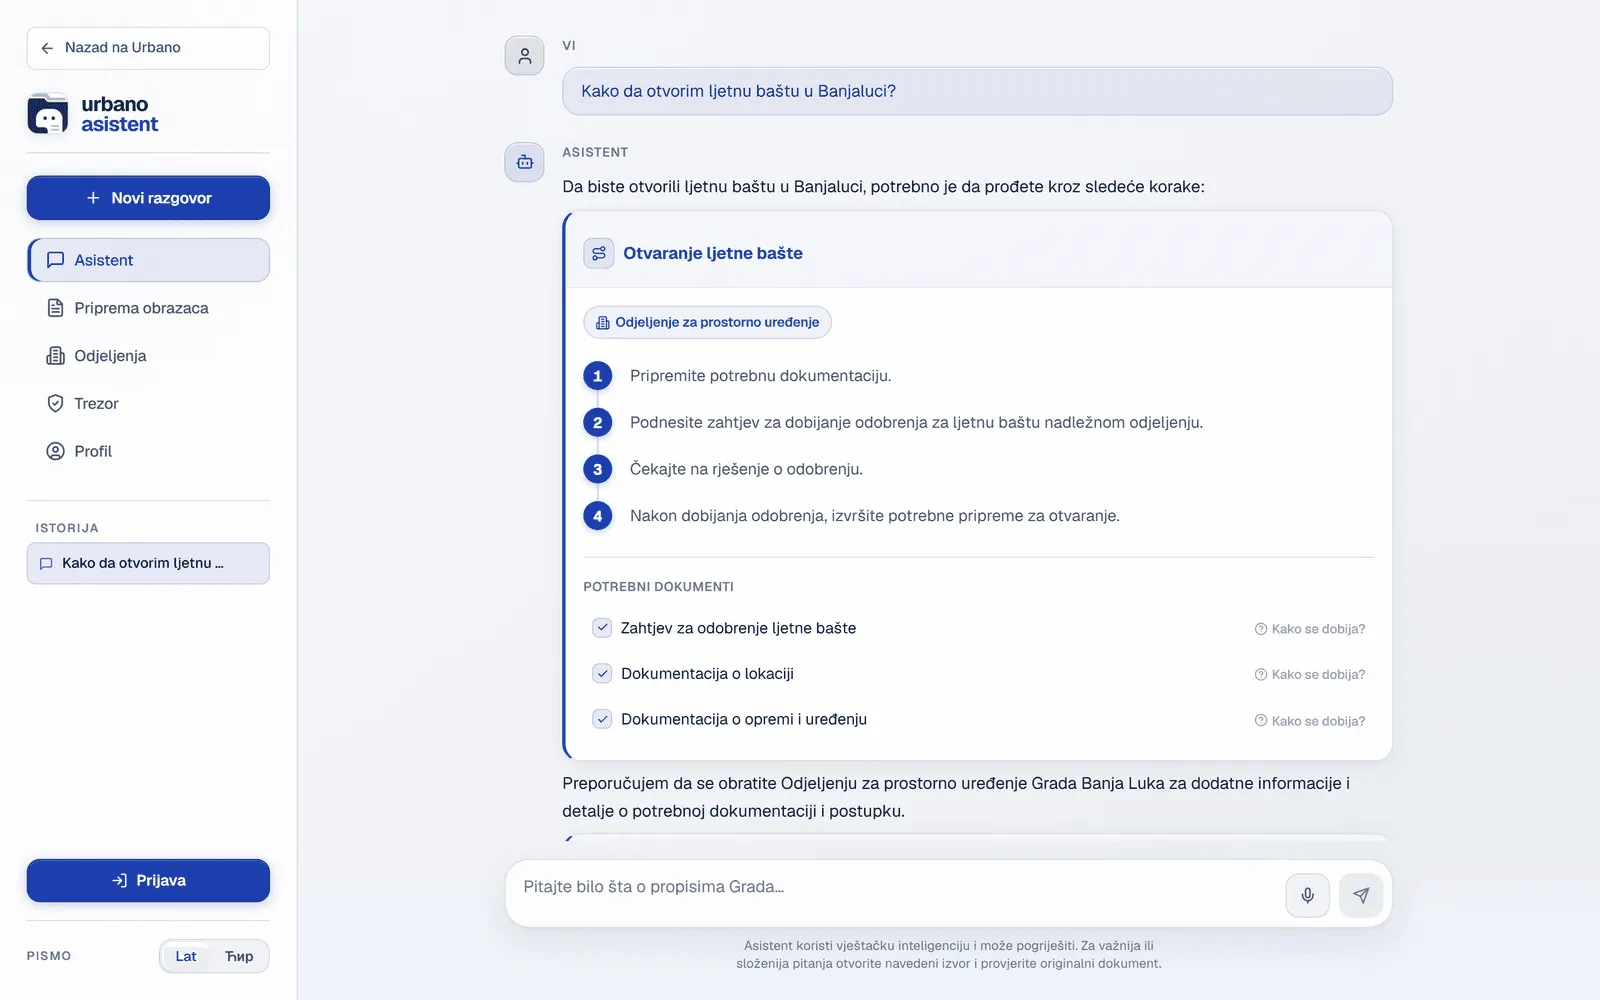
Das Modell bekommt die Frage zusammen mit den gefundenen Passagen und der Anweisung, nur daraus zu antworten. Ein vertrauenswürdiger Assistent zeigt dann seine Quellen: welches Dokument, welcher Abschnitt. Wer die Antwort liest, kann das Original öffnen und selbst entscheiden.
Genauso wichtig: Der Assistent muss sagen dürfen, dass er etwas nicht weiß. Wenn die Dokumente keine Antwort enthalten, ist ein klares „Dazu habe ich nichts gefunden“ — und ein Weg zu einem Menschen — mehr wert als eine flüssige Vermutung.
Zwei Beispiele aus meiner Arbeit
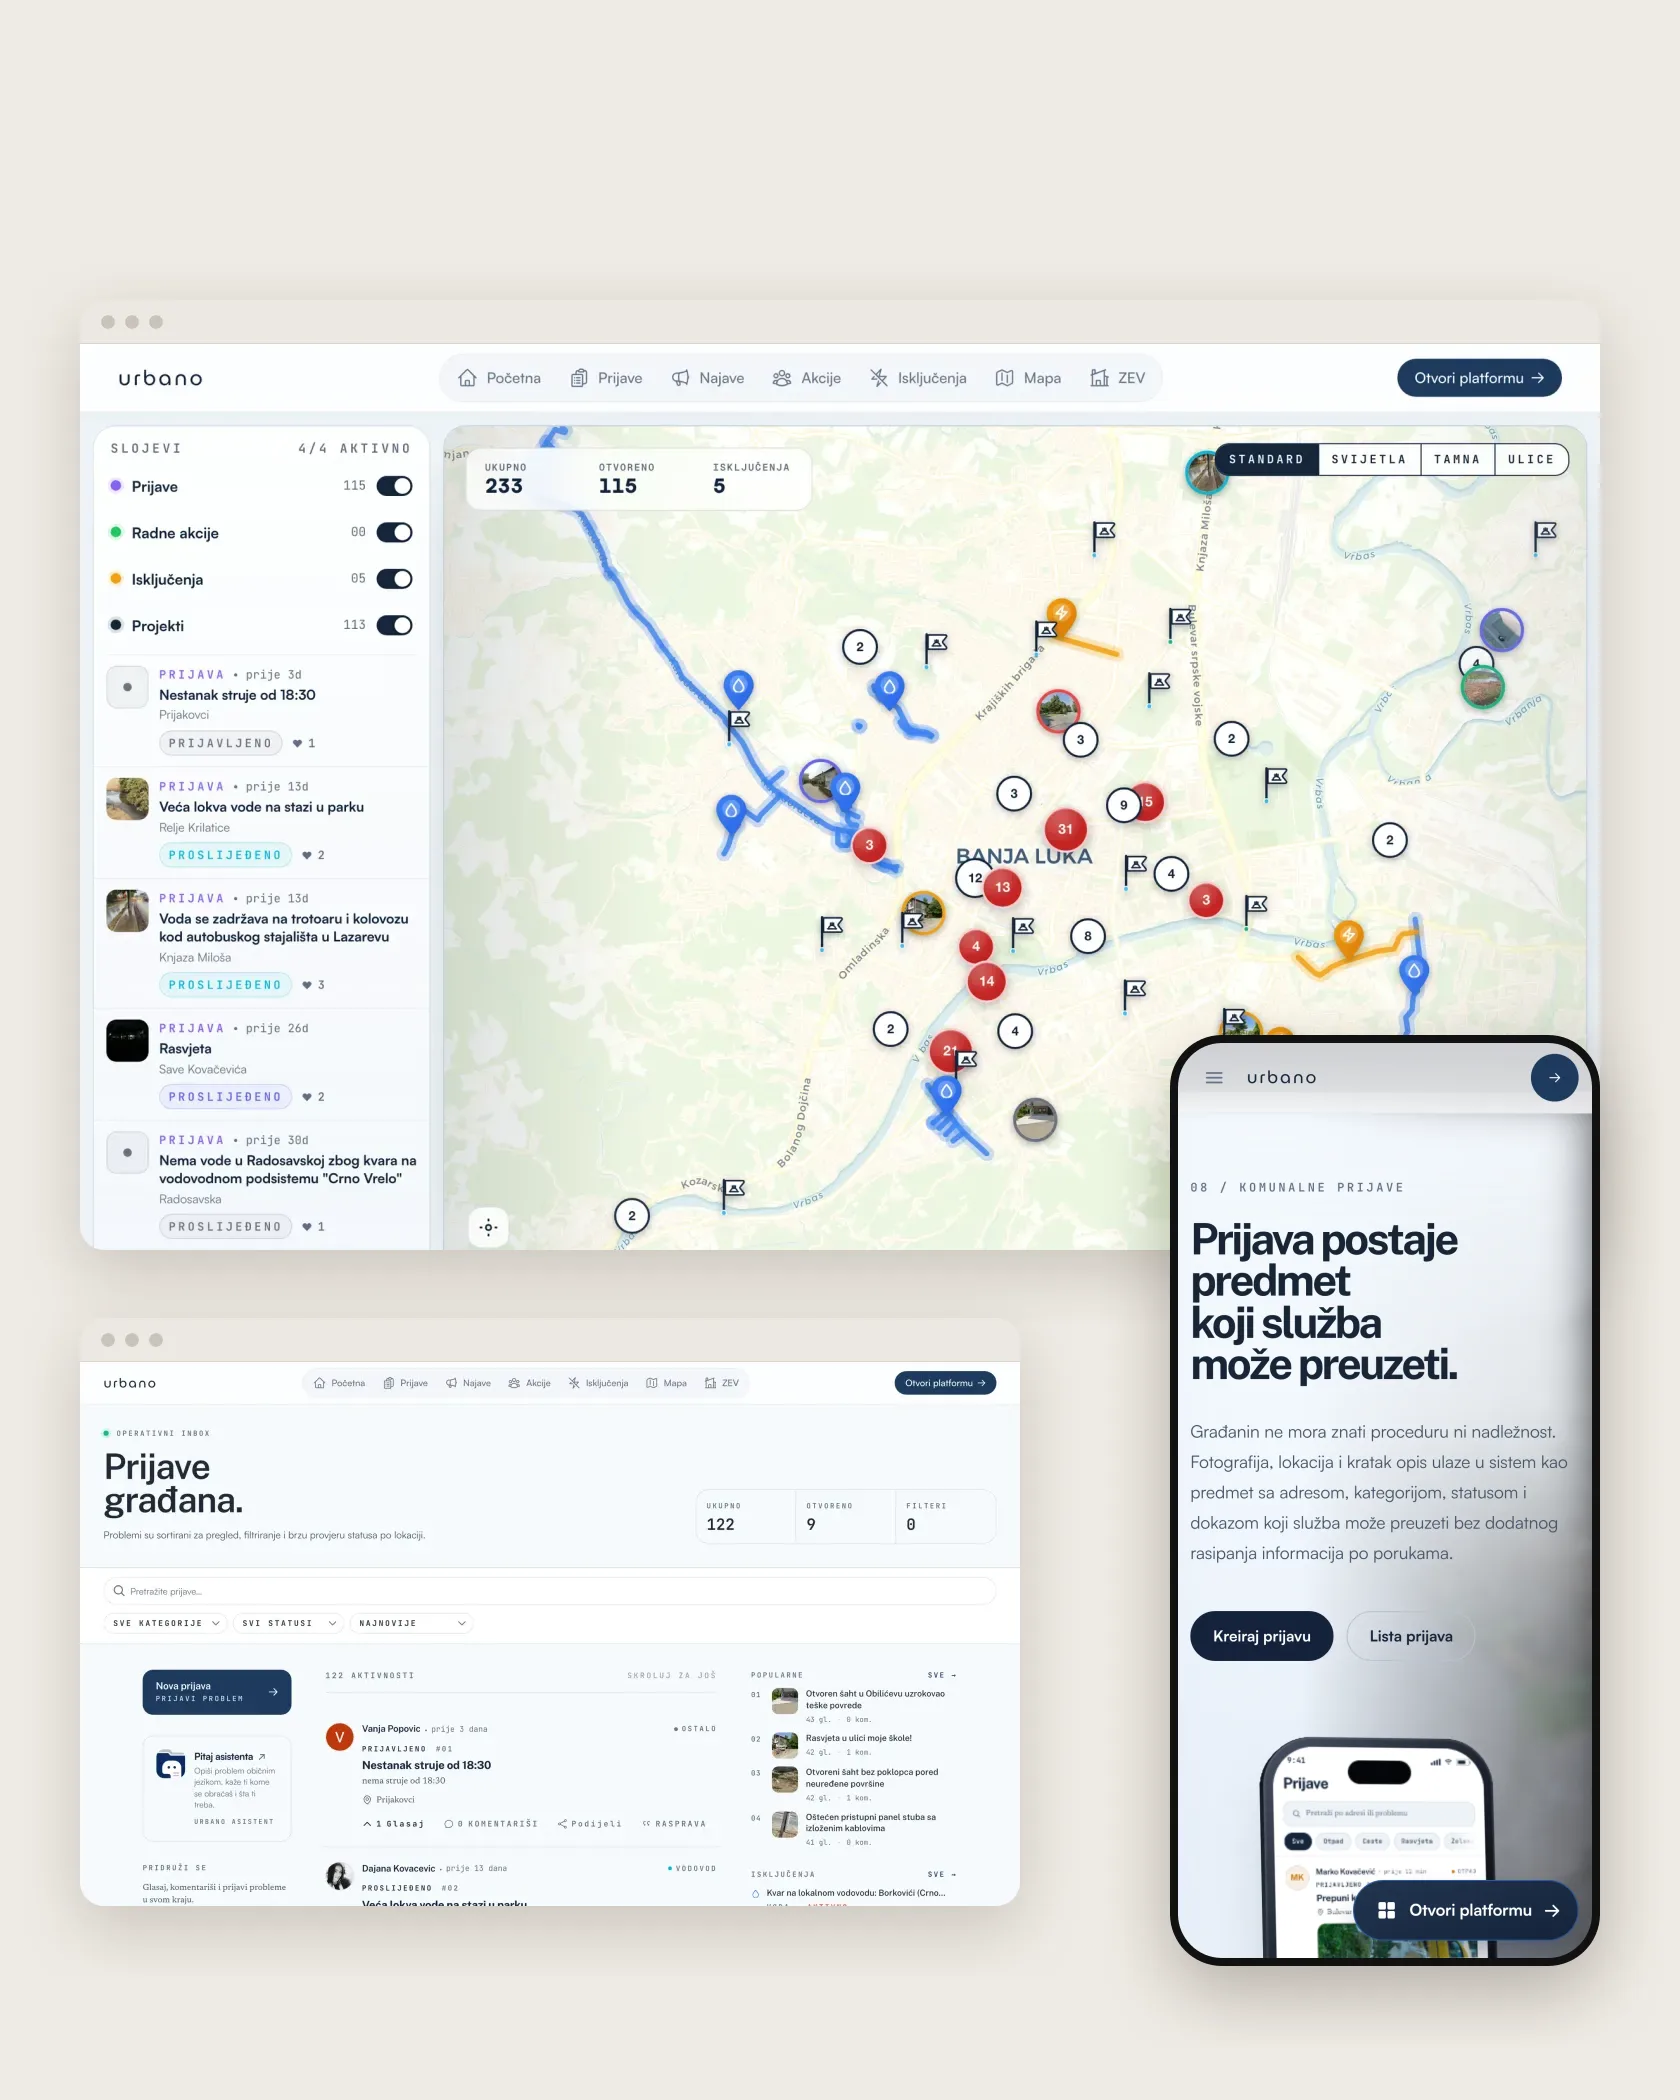
Urbano ist eine live geschaltete Bürgerplattform für Banja Luka. Ihr Assistent arbeitet mit 22.300 städtischen Dokumenten und ist Teil desselben Produkts wie die Bürger-App, die Verwaltungskonsole und 143 Behördenformulare. Bürgerinnen und Bürger fragen in Alltagssprache; die Antwort entsteht aus den eigenen Quellen der Stadt, und die Frage kann direkt in den passenden Dienst übergehen.
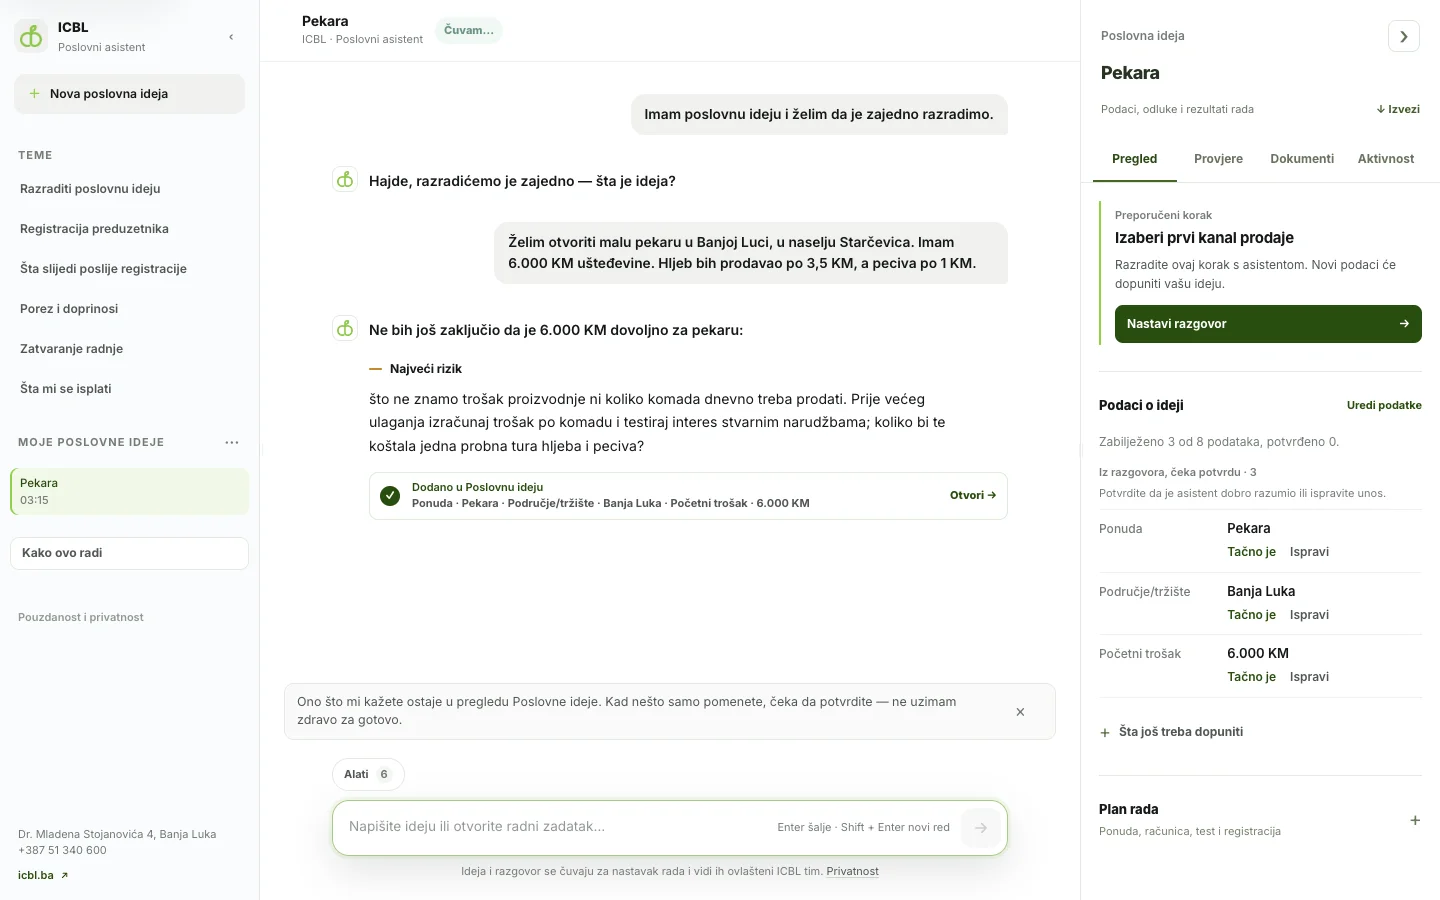
Für das Innovationszentrum Banja Luka baue ich einen Business-Assistenten, der sich noch in Entwicklung befindet. Hier geht es weniger darum, eine einzelne Tatsache nachzuschlagen, als ein Gespräch zu führen: Förderprogramme erklären, durch die Firmengründung begleiten und einen ersten Businessplan strukturieren. Retrieval bleibt wichtig, weil die Programme Regeln haben, denen die Antworten folgen müssen.
Retrieval muss nicht Text sein
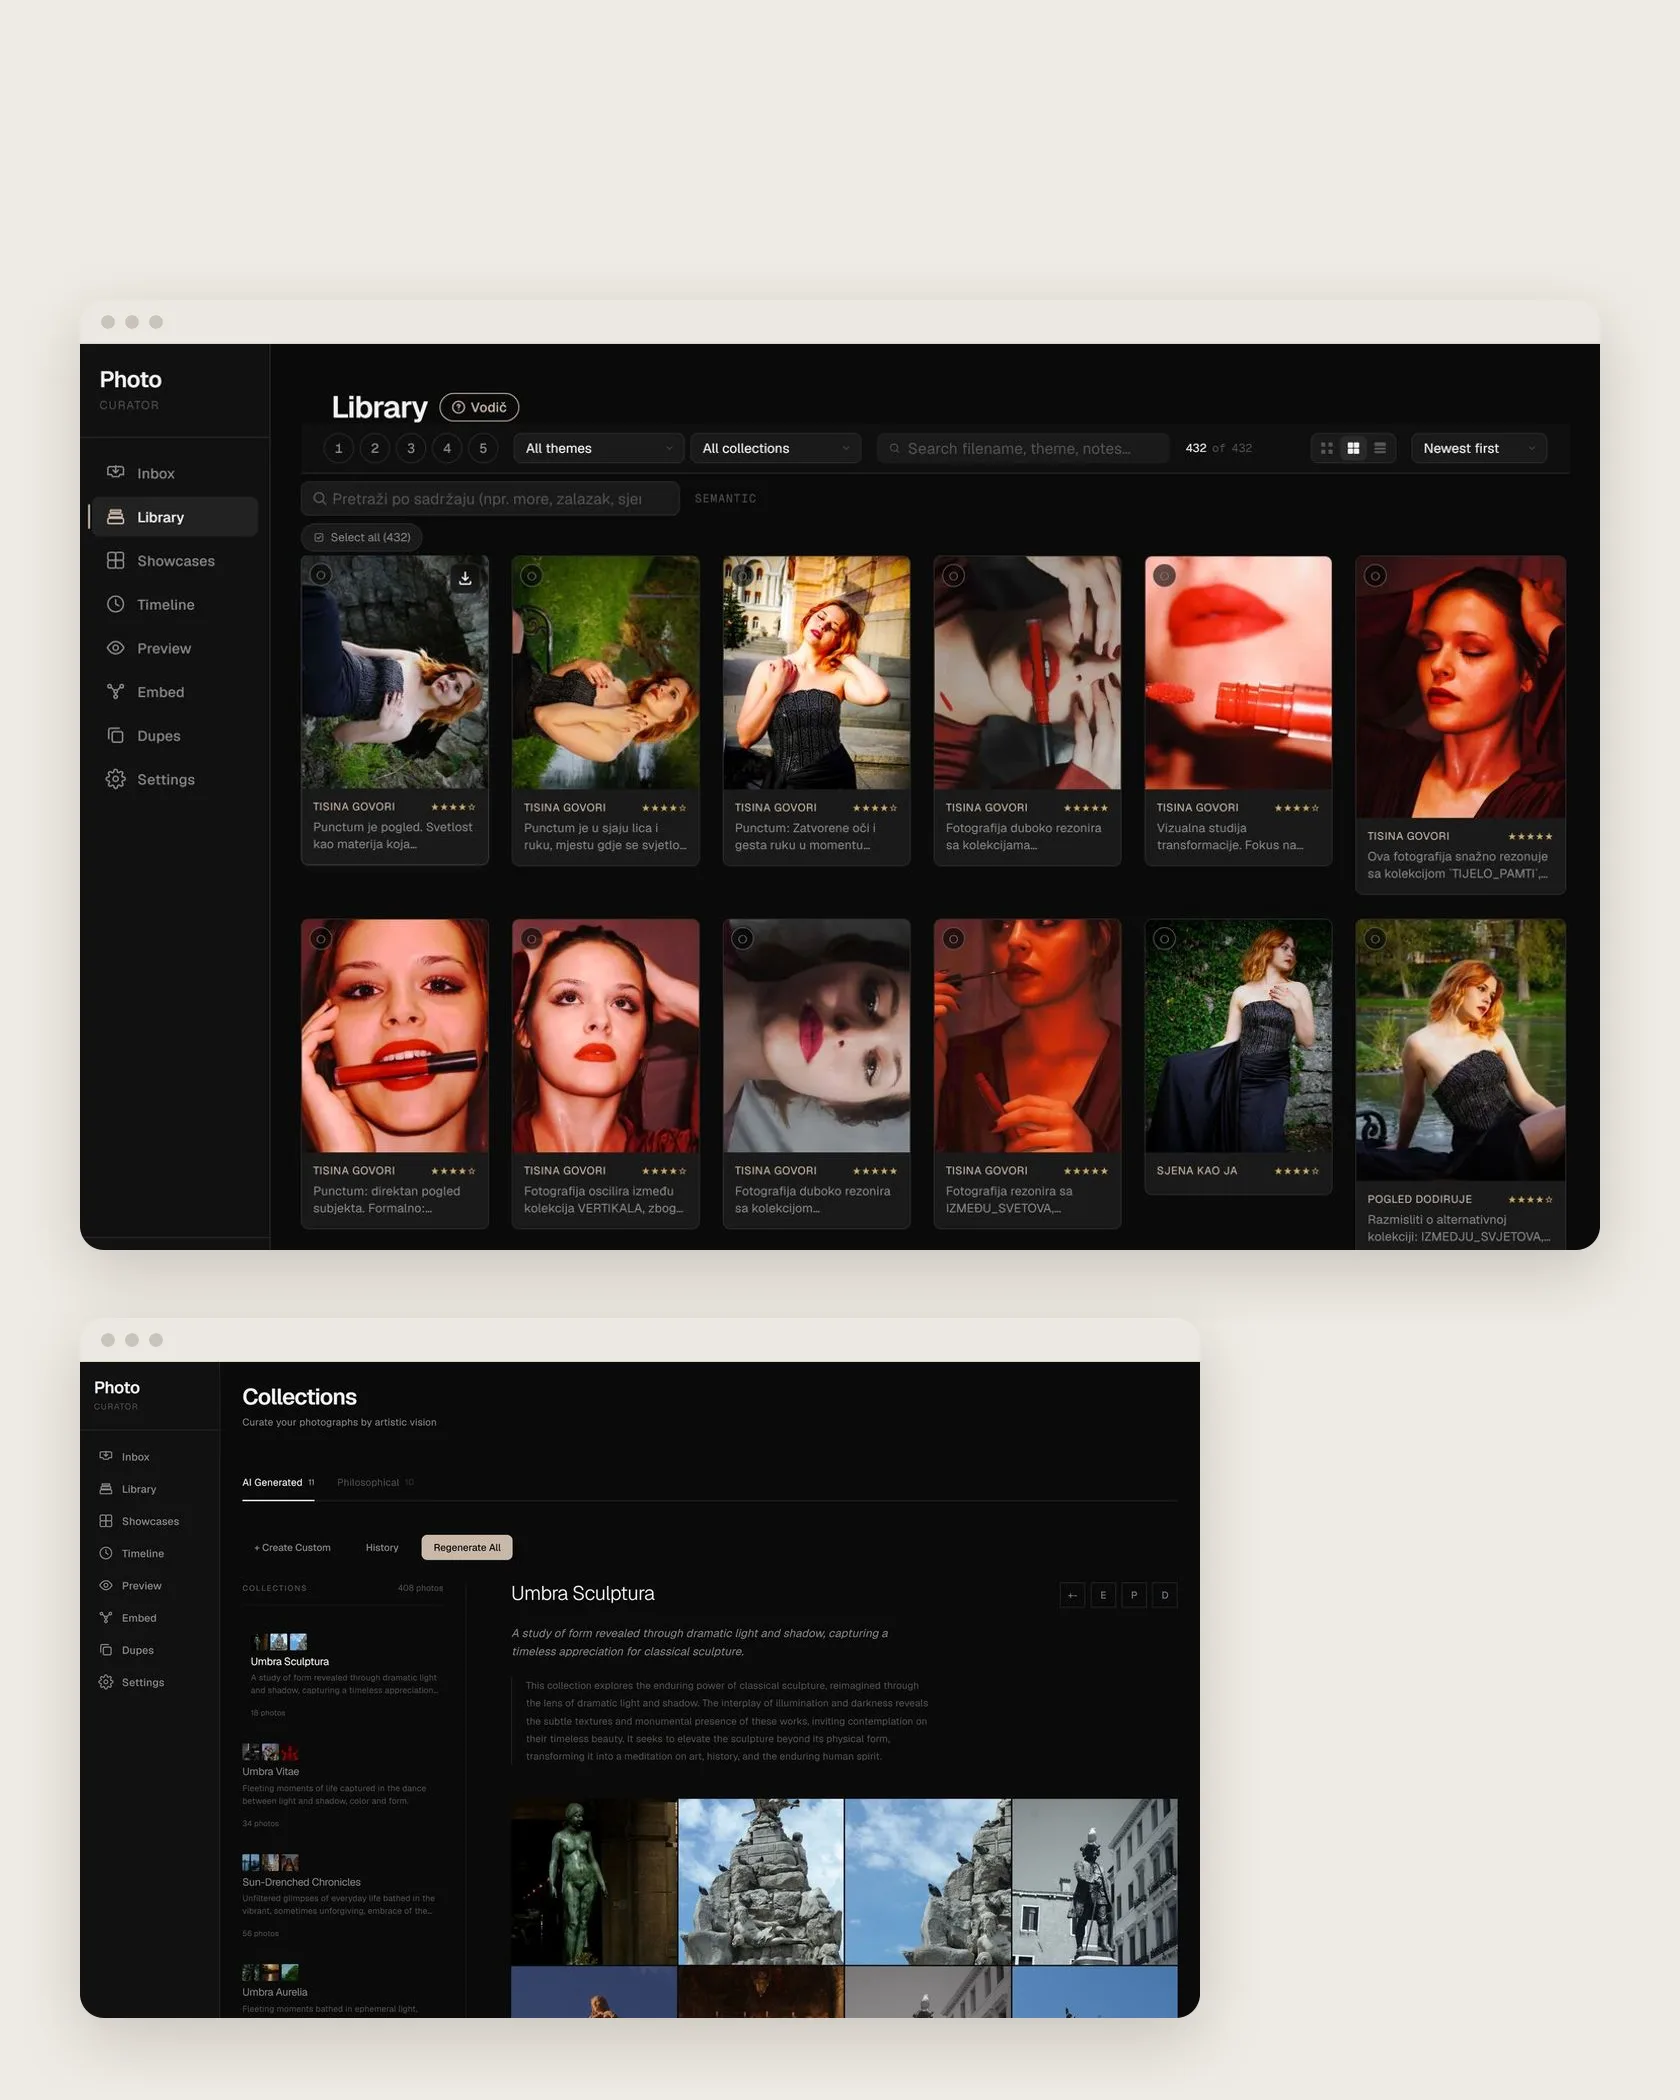
Dasselbe Prinzip funktioniert mit Bildern. Curation Engine, ein privates Produkt, das ich entworfen und gebaut habe, liest ein Fotoarchiv über visuelle und Text-Embeddings. Ein Fotograf kann mit Worten nach einer Stimmung oder einem Motiv suchen, ähnliche Aufnahmen finden und Gruppen verwandter Bilder sehen; die gefundenen Fotos werden zum Material für eine Auswahl.
Die Lehre gilt auch für Geschäftsdokumente: Entscheidend ist nicht das Chatfenster, sondern ob das System das richtige Material findet, es klar zeigt und die Entscheidung dem Menschen überlässt.
Was die Nutzer tatsächlich sehen
Ein Assistent ist Teil einer Oberfläche, kein Ersatz dafür. Vorgeschlagene Fragen zeigen, was man fragen kann. Quellen öffnen sich direkt an Ort und Stelle, sodass das Prüfen einer Antwort einen Klick dauert. Führt die Antwort zu einer Handlung — einem Formular, einem Termin, einer Meldung —, sollte der nächste Schritt gleich daneben liegen, so wie bei Urbano, wo Informationen und die 143 Behördenformulare im selben Produkt leben.
Auch Ausweichwege gehören zum Design: eine klare Meldung, wenn nichts Relevantes gefunden wurde, eine Möglichkeit, die Frage umzuformulieren, und ein Weg zu einem Menschen. Diese Details entscheiden darüber, ob Menschen dem Assistenten nach der ersten Woche noch vertrauen.
Testen, ob es funktioniert
Ein Assistent sollte getestet werden wie jeder andere Teil eines Produkts. Vor dem Start sammle ich echte Fragen — die, die Mitarbeitende tatsächlich bekommen — zusammen mit den Antworten und Quellen, die herauskommen sollten, und prüfe Retrieval und Antworten daran. Ändern sich Dokumente oder Einstellungen, läuft derselbe Satz erneut.
Nach dem Start sind die Fragen, die Menschen wirklich stellen, der beste Lehrer. Unbeantwortete Fragen zeigen fehlende Dokumente; falsche Antworten deuten meist auf ein Retrieval-Problem; wiederkehrende Fragen zeigen, was auf der Website selbst besser erklärt werden sollte.
Datenschutz und Ihre Dokumente
Unternehmensdokumente sind oft vertraulich. Bevor irgendetwas gebaut wird, lohnt es sich festzulegen, welche Dokumente der Assistent nutzen darf, wer ihn was fragen darf und wo Daten und Modell laufen. Ein interner Assistent für Mitarbeitende und ein öffentlicher Assistent für Kunden brauchen meist unterschiedliche Dokumente und unterschiedliche Berechtigungen.
Personenbezogene Daten verdienen besondere Sorgfalt: Was in den Index kommt, wie lange Gespräche gespeichert werden und wer sie lesen kann, sind Entscheidungen für den Anfang, nicht für die Zeit nach dem Start.
Was die Kosten treibt — und wann man keinen bauen sollte
Der Aufwand hängt vor allem von den Dokumenten ab: wie viele es sind, wie unordentlich sie sind, wie oft sie sich ändern und ob sie Texterkennung brauchen. Er hängt auch davon ab, wie der Assistent genutzt wird — von einigen Mitarbeitenden oder von der Öffentlichkeit — und womit er sonst verbunden werden muss, etwa Formularen, Konten oder einem Kalender.
Manchmal lautet die ehrliche Antwort, keinen zu bauen. Gibt es zwanzig Fragen mit stabilen Antworten, ist eine gut geschriebene Seite mit Antworten schneller, günstiger und leichter aktuell zu halten. Ein RAG-Assistent lohnt sich, wenn es viele Dokumente gibt, dieselben Fragen immer wiederkommen und die Antwort von Hand zu suchen echte Zeit kostet.
Wenn das nach Ihrer Situation klingt, schicken Sie mir, welche Art von Dokumenten Sie haben, wer die Fragen stellen würde und was diese Menschen danach tun können sollen.