Il problema che un chatbot generico non può risolvere
Chieda a un chatbot generico delle procedure della Sua azienda e succede una di due cose. O dice di non saperlo oppure — peggio — produce una risposta sicura di sé che sembra giusta e non lo è. Non ha mai visto i Suoi documenti, quindi riempie il vuoto con qualcosa di plausibile.
Per un’azienda, tutta la difficoltà sta qui. Le conoscenze che contano per i Suoi clienti e collaboratori vivono in contratti, regolamenti, listini, manuali, decisioni e vecchie email. Un modello addestrato sull’internet pubblico non ne ha nessuna, e riaddestrare un modello sui Suoi file raramente è la risposta giusta.
Cosa fa la RAG, in una frase
La retrieval-augmented generation aggiunge un passaggio prima della risposta: prima trovare nei Suoi documenti i passaggi pertinenti alla domanda, poi consegnarli al modello e chiedergli di rispondere a partire da quelli.
Un’analogia aiuta. Un chatbot generico è una persona molto colta che risponde a memoria. Un assistente RAG è la stessa persona con il Suo archivio sulla scrivania, che controlla prima di parlare — e sa dirLe da quale pagina viene la risposta.
Preparare i documenti
Gran parte del lavoro avviene prima che qualcuno faccia una domanda. I documenti arrivano come PDF, scansioni, fogli di calcolo e pagine web, e prima devono diventare testo pulito e leggibile. Le pagine scansionate richiedono il riconoscimento del testo; tabelle e titoli devono conservare il loro significato; duplicati e versioni superate vanno rimossi o segnalati.
Il testo viene poi suddiviso in passaggi: un paragrafo, una clausola, una breve sezione. Questo si chiama chunking. Passaggi troppo lunghi portano rumore nella risposta; passaggi troppo brevi perdono il contesto. Ogni passaggio conserva l’indicazione della sua provenienza: il documento, la pagina, la data.
Ogni passaggio viene quindi trasformato in un embedding: una sequenza di numeri che ne rappresenta il significato. Due passaggi che parlano della stessa cosa con parole diverse finiscono vicini l’uno all’altro. È ciò che permette di cercare per significato anziché per parole esatte, e viene conservato in un database vettoriale come pgvector, quello alla base di Urbano.
Trovare i passaggi giusti
Quando qualcuno fa una domanda, anche la domanda viene trasformata in un embedding, e il sistema cerca i passaggi più vicini. Un buon recupero raramente si ferma qui: può combinare il significato con la normale ricerca per parole chiave, filtrare per tipo di documento o data e riordinare i risultati prima che qualcosa arrivi al modello.
È nel recupero che un sistema RAG riesce o fallisce. Se il passaggio giusto non viene trovato, il miglior modello del mondo risponderà dal materiale sbagliato. In un assistente serio, la maggior parte dello sforzo va qui, non nella finestra di conversazione.
Una risposta che si può verificare
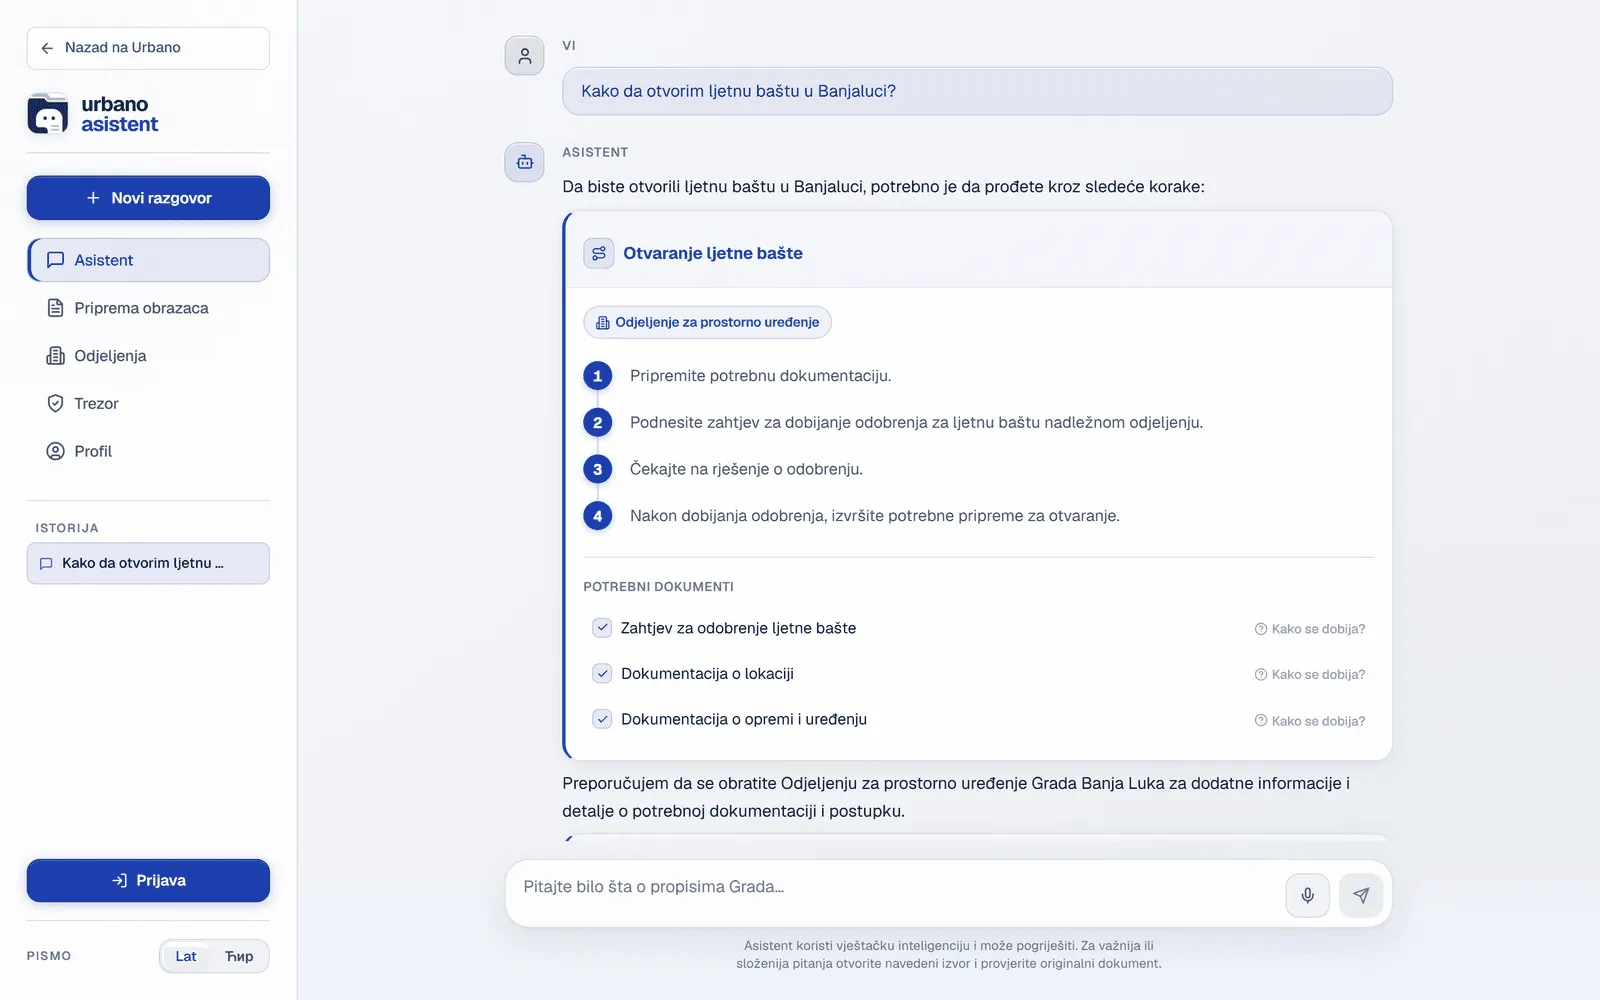
Il modello riceve la domanda insieme ai passaggi recuperati e all’istruzione di rispondere soltanto a partire da essi. Un assistente affidabile mostra poi le sue fonti: quale documento, quale sezione. Chi legge la risposta può aprire l’originale e giudicare da sé.
Altrettanto importante, l’assistente deve poter dire di non sapere. Quando i documenti non contengono una risposta, un chiaro «Non sono riuscito a trovarlo» — e un modo per arrivare a una persona — vale più di un’ipotesi scorrevole.
Due esempi dal mio lavoro
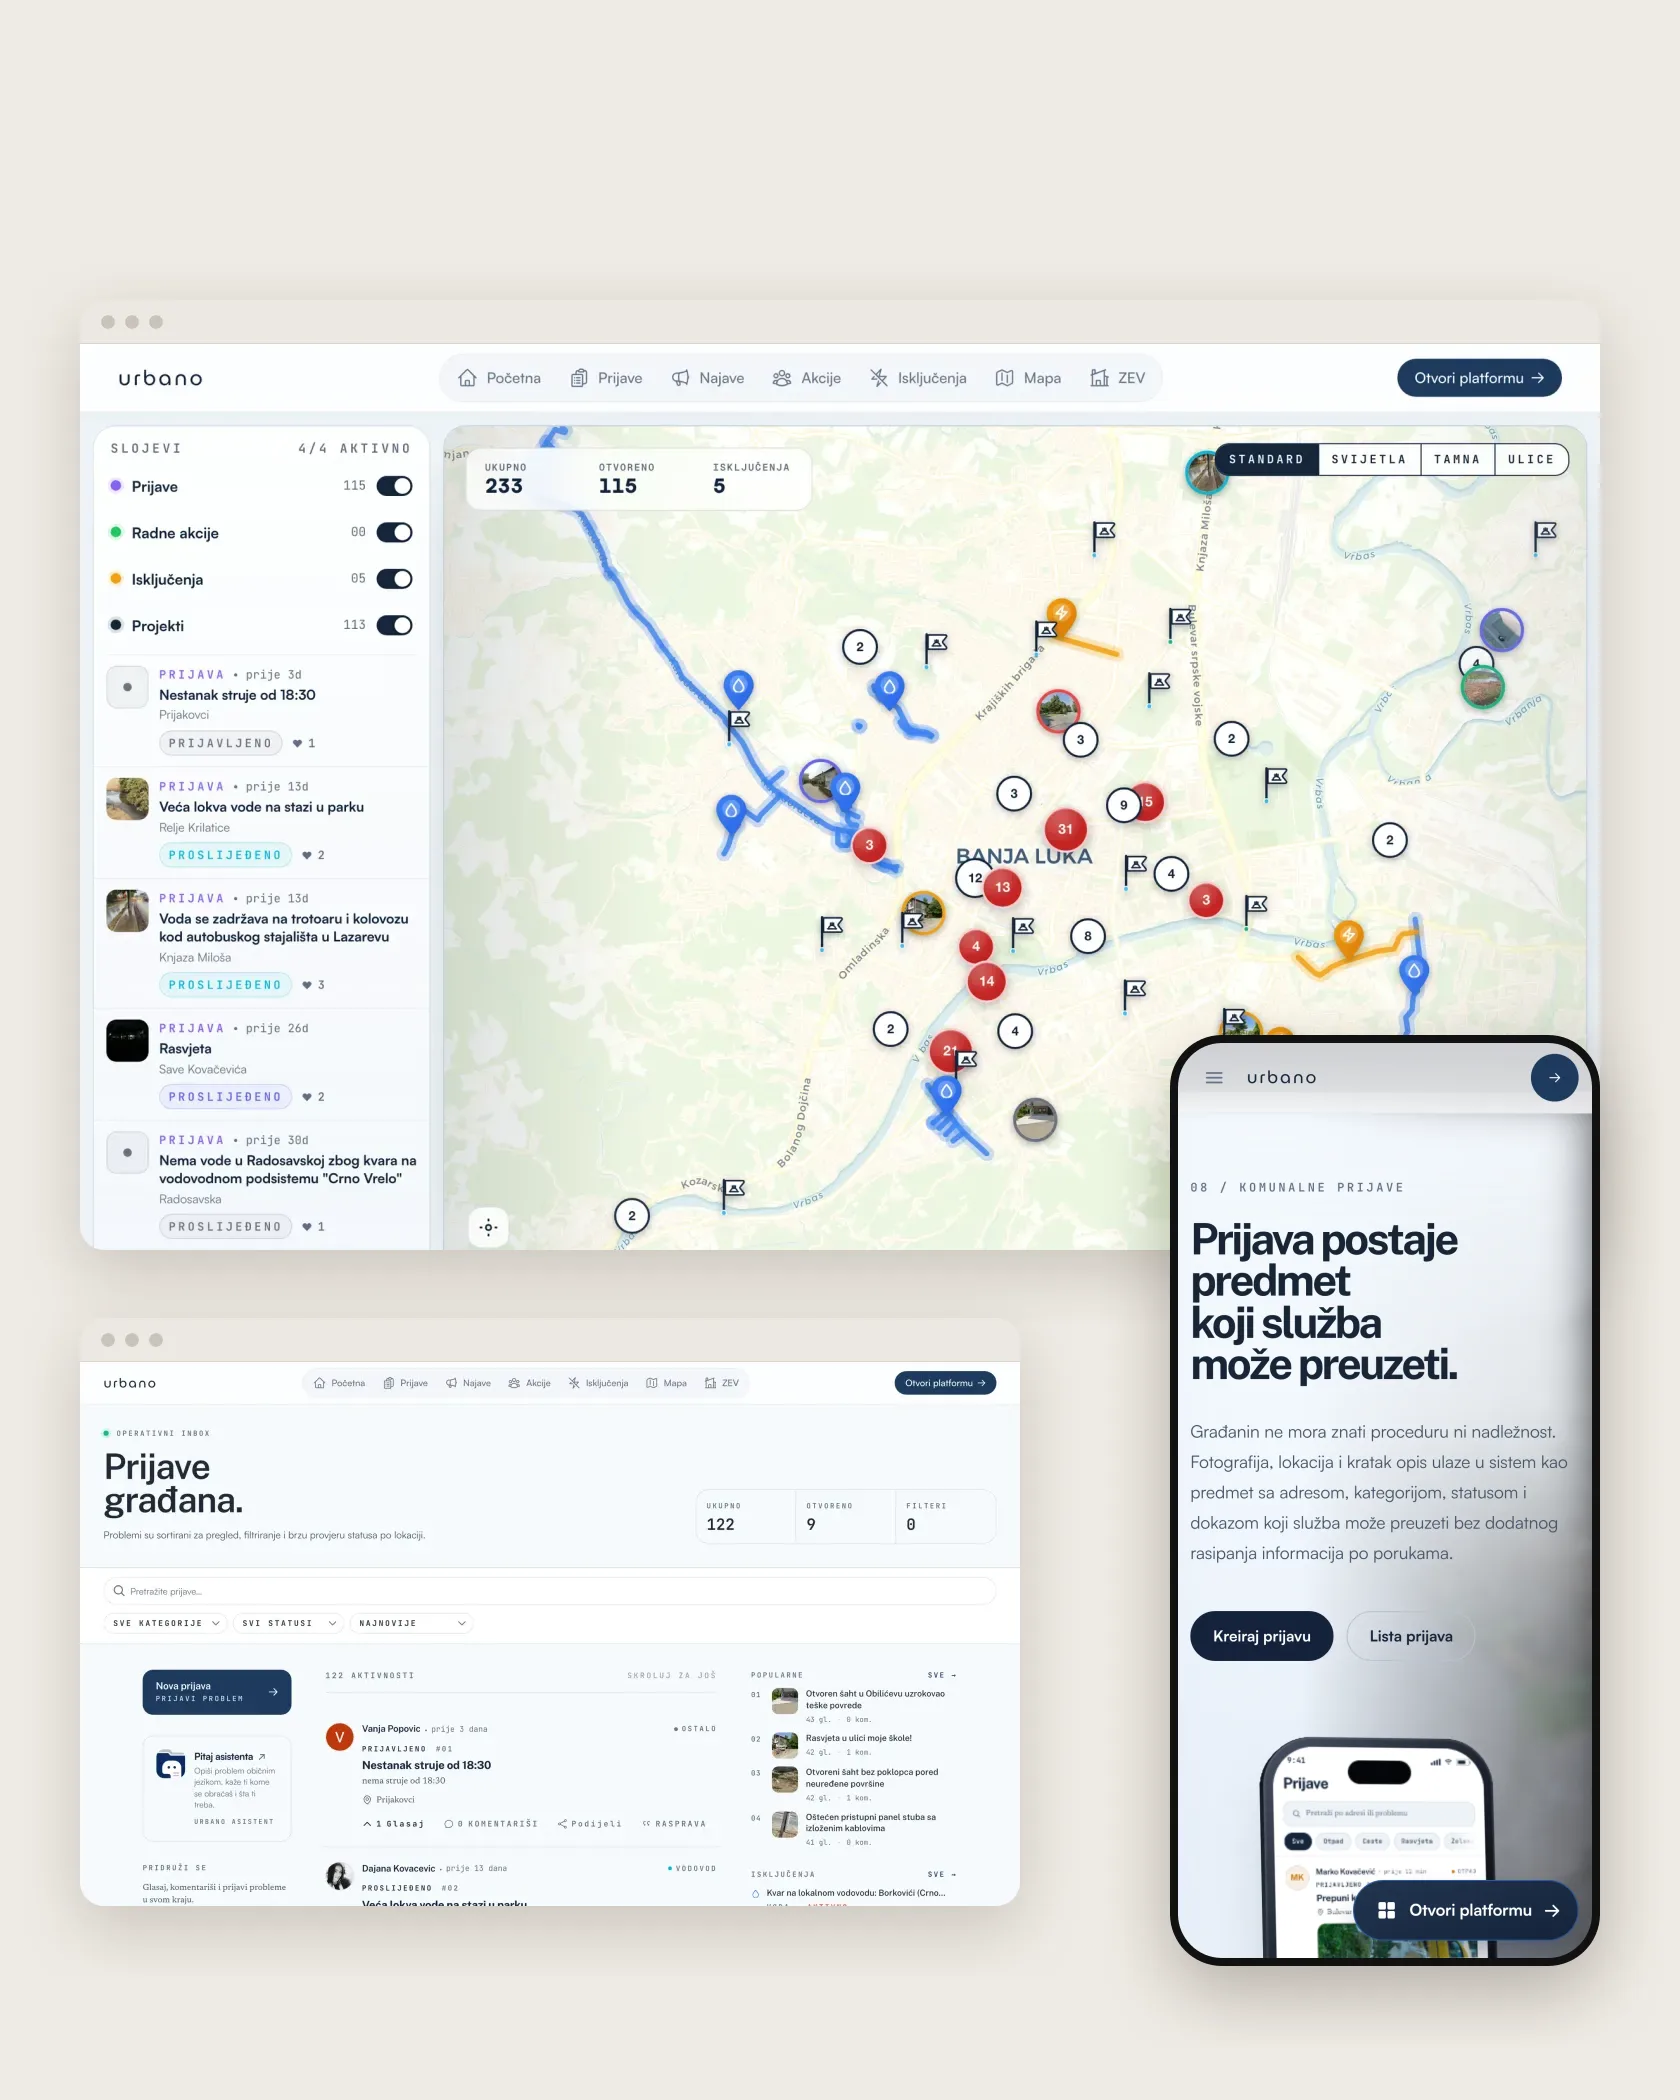
Urbano è una piattaforma civica online per Banja Luka. Il suo assistente lavora su 22.300 documenti comunali e si trova all’interno dello stesso prodotto che comprende l’app per i cittadini, la console amministrativa e 143 moduli ufficiali. Il cittadino chiede con parole comuni; la risposta è costruita a partire dalle fonti della città, e la domanda può proseguire nel servizio corrispondente.
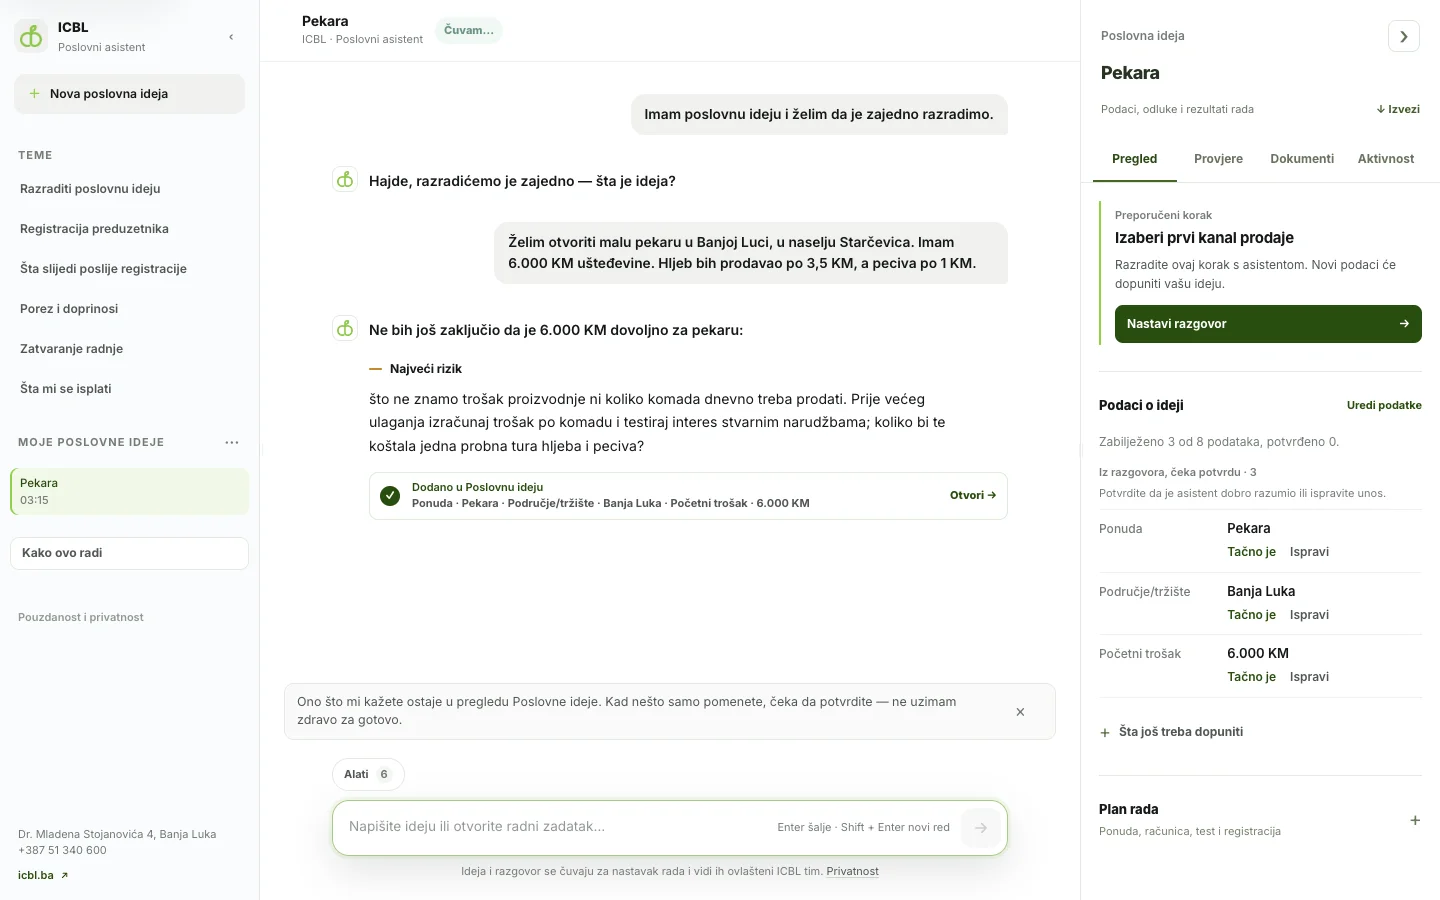
Per il Centro per l’innovazione di Banja Luka sto realizzando un assistente per le imprese, ancora in fase di sviluppo. Qui il compito non è tanto cercare un singolo dato quanto guidare una conversazione: spiegare i programmi di sostegno, accompagnare la registrazione di un’impresa e strutturare un primo business plan. Il recupero resta importante, perché i programmi hanno regole che le risposte devono rispettare.
Il recupero non deve essere per forza testuale
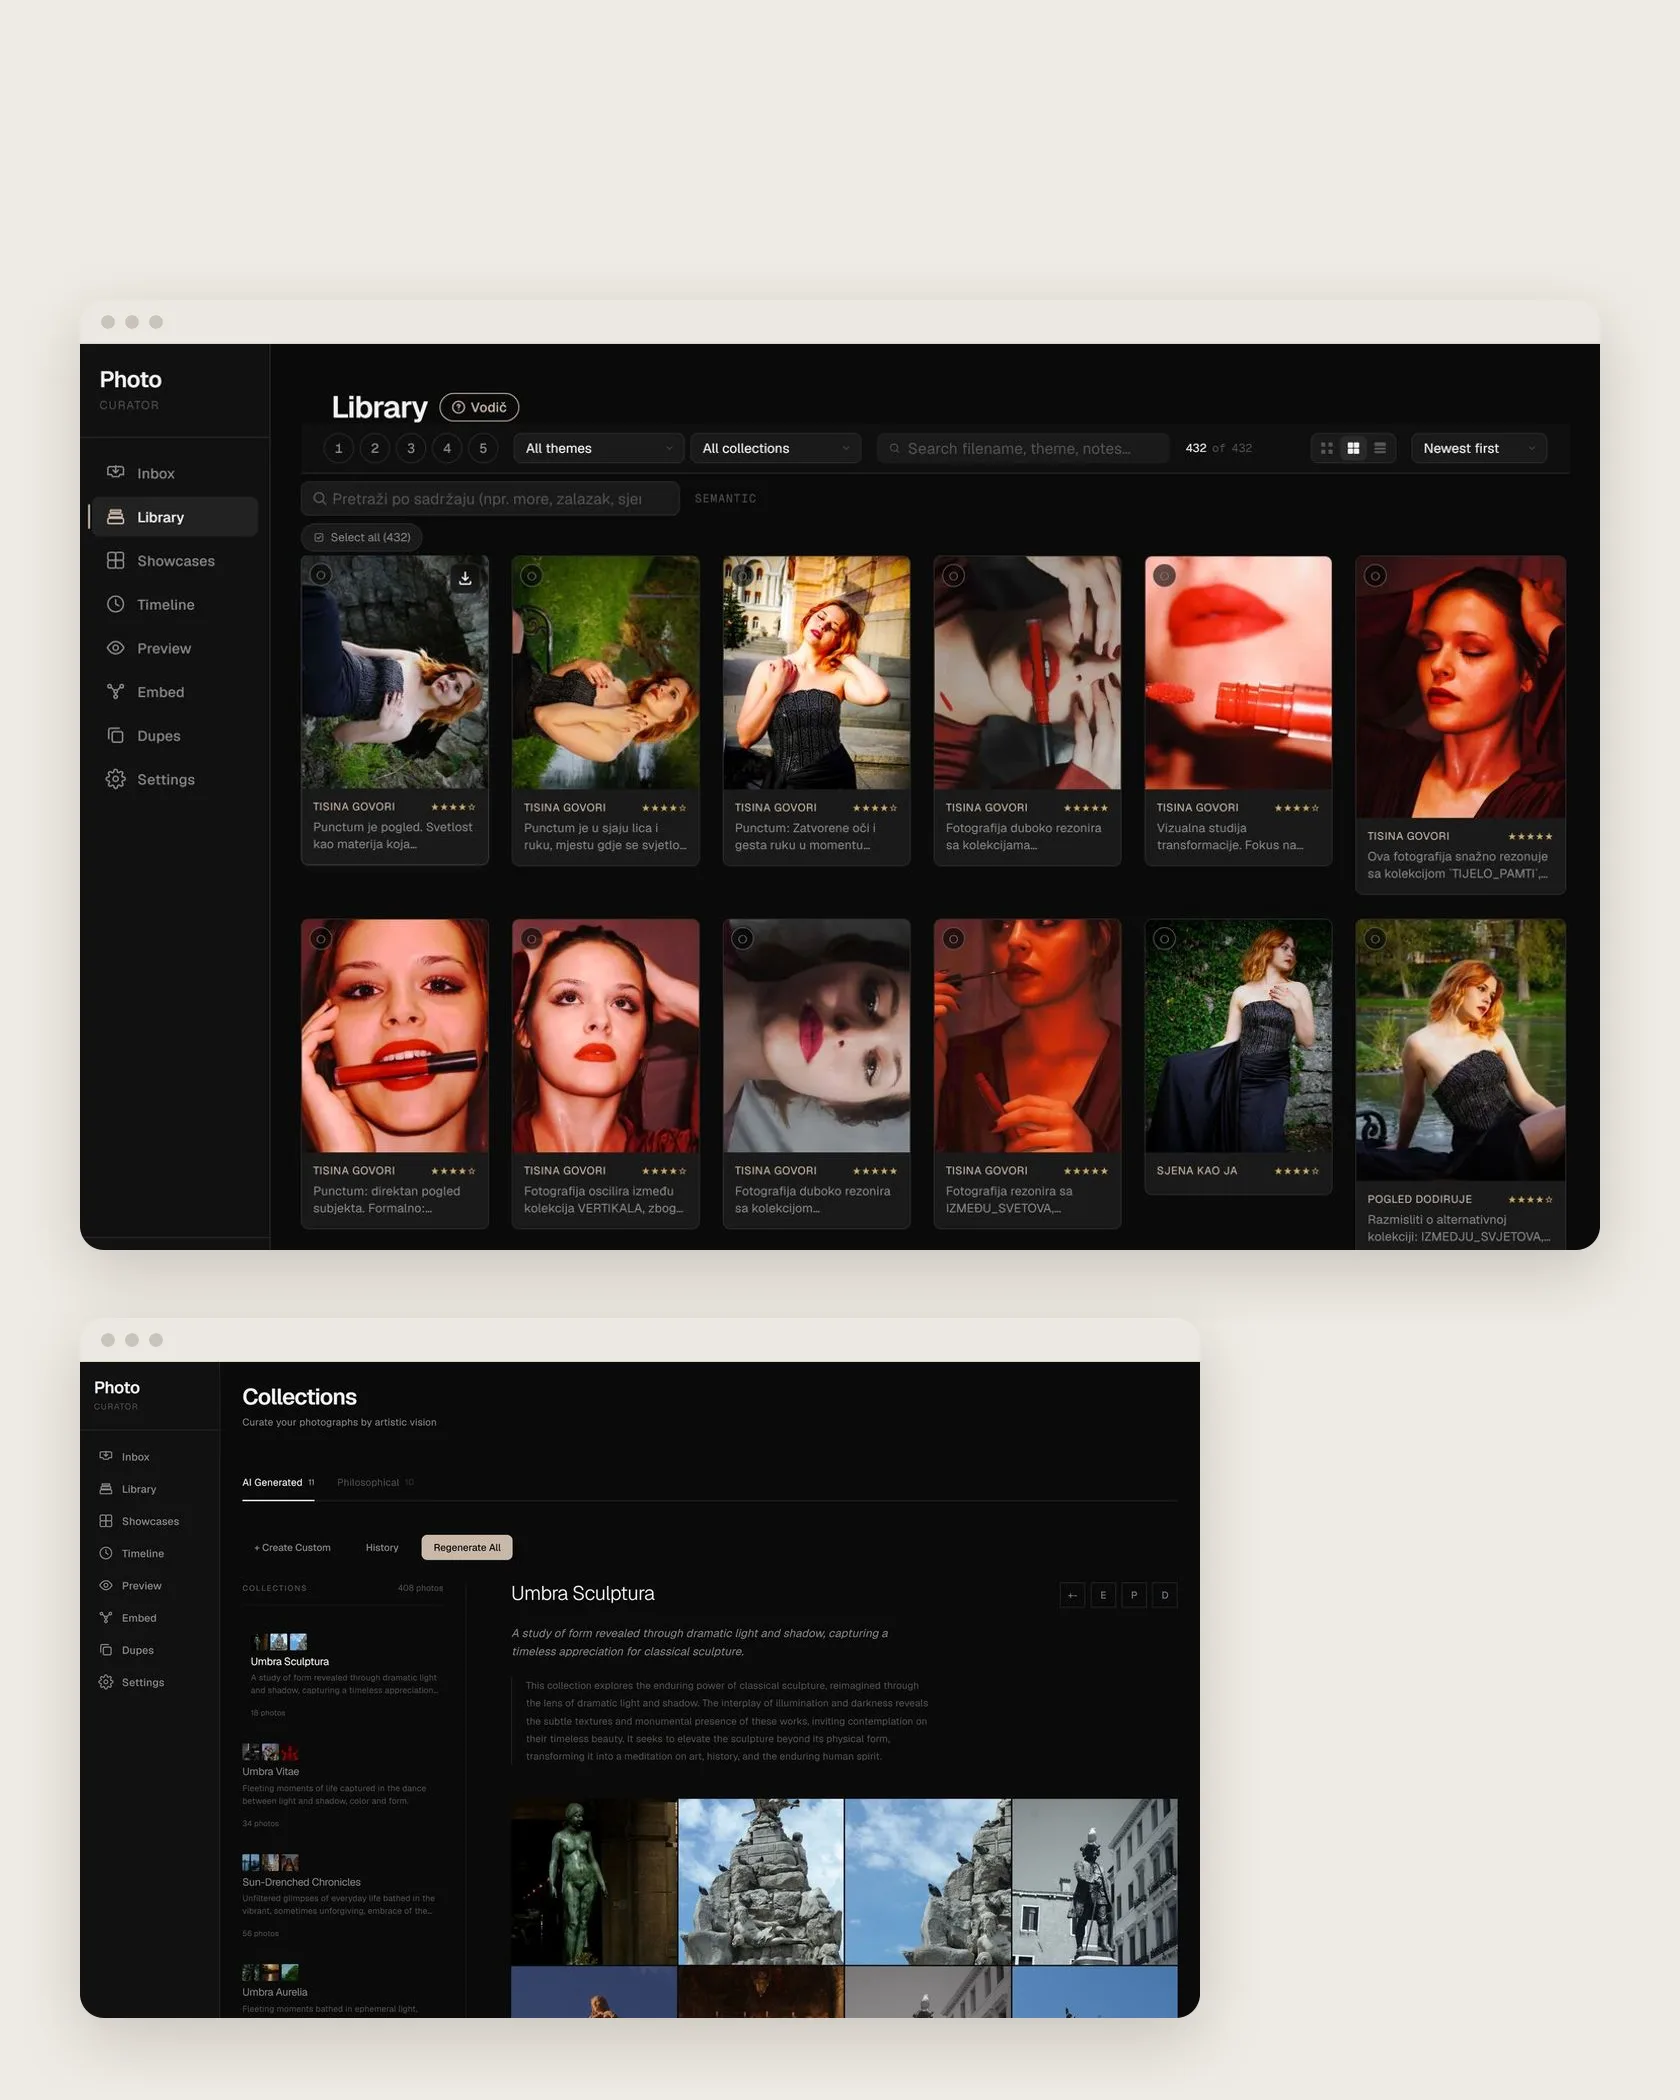
La stessa idea funziona con le immagini. Curation Engine, un prodotto privato che ho progettato e realizzato, legge un archivio fotografico attraverso embedding visivi e testuali. Un fotografo può cercare a parole un’atmosfera o un soggetto, trovare scatti che si somigliano e vedere gruppi di immagini correlate, e le fotografie recuperate diventano il materiale per una selezione.
La lezione vale anche per i documenti aziendali: ciò che conta non è la finestra di chat, ma che il sistema trovi il materiale giusto, lo mostri con chiarezza e lasci la decisione alla persona.
Cosa vede davvero chi lo usa
Un assistente fa parte di un’interfaccia, non la sostituisce. Le domande suggerite mostrano alle persone cosa possono chiedere. Le fonti si aprono sul posto, così verificare una risposta richiede un clic. Quando la risposta porta a un’azione — un modulo, un appuntamento, una segnalazione — il passo successivo dovrebbe essere lì, come in Urbano, dove informazioni e 143 moduli ufficiali convivono nello stesso prodotto.
Anche le soluzioni di riserva fanno parte del progetto: un messaggio chiaro quando non è stato trovato nulla di pertinente, un modo per riformulare e un modo per raggiungere una persona. Sono questi dettagli a decidere se le persone si fidano dell’assistente dopo la prima settimana.
Verificare che funzioni
Un assistente va testato come qualsiasi altra parte di un prodotto. Prima del lancio raccolgo domande reali — quelle che il personale riceve davvero — insieme alle risposte e alle fonti che dovrebbero produrre, e controllo recupero e risposte rispetto a esse. Quando cambiano i documenti o le impostazioni, si esegue di nuovo lo stesso insieme.
Dopo il lancio, le domande che le persone fanno davvero sono il miglior maestro. Le domande senza risposta rivelano documenti mancanti; le risposte sbagliate di solito indicano un problema di recupero; le domande ripetute mostrano cosa andrebbe spiegato meglio direttamente sul sito.
Privacy e i Suoi documenti
I documenti aziendali sono spesso riservati. Prima di costruire qualsiasi cosa conviene decidere quali documenti l’assistente può usare, chi può chiedergli cosa e dove girano i dati e il modello. Un assistente interno per il personale e un assistente pubblico per i clienti di solito richiedono insiemi di documenti e autorizzazioni diversi.
I dati personali meritano un’attenzione particolare: cosa entra nell’indice, per quanto tempo si conservano le conversazioni e chi può leggerle sono decisioni da prendere all’inizio, non dopo il lancio.
Cosa determina i costi, e quando non realizzarlo
L’impegno dipende soprattutto dai documenti: quanti sono, quanto sono disordinati, quanto spesso cambiano e se richiedono il riconoscimento del testo. Dipende anche da come viene usato l’assistente — da pochi collaboratori o dal pubblico — e da cos’altro deve collegare, come moduli, account o un calendario.
A volte la risposta onesta è non realizzarlo. Se ci sono venti domande con risposte stabili, una pagina di risposte ben scritta è più veloce, più economica e più facile da mantenere corretta. Un assistente RAG si guadagna il suo posto quando i documenti sono molti, le stesse domande continuano a tornare e trovare la risposta a mano richiede tempo reale.
Se Le sembra la Sua situazione, mi scriva che tipo di documenti ha, chi farebbe le domande e cosa dovrebbe poter fare dopo.